Gemini 4 Argon 参数与评测,对比 GPT-6 Astra 和 Claude Fable 5.1 该选谁
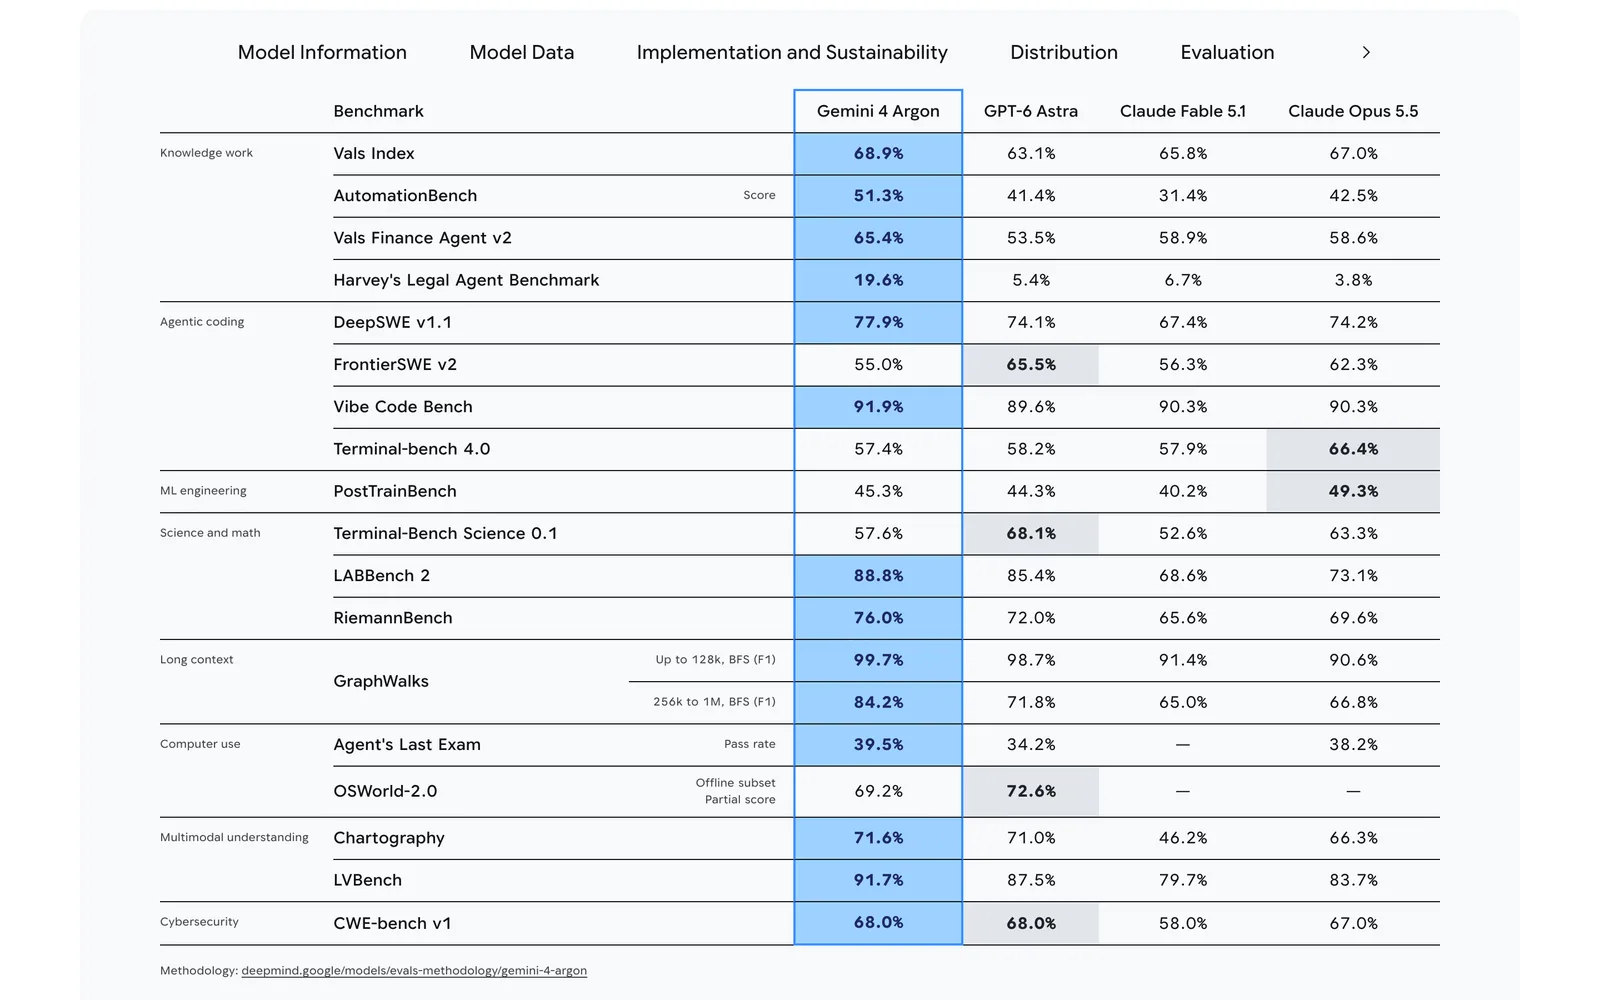
Gemini 4 Argon 发布第二天,我把模型卡里 19 项评测一个格一个格抄了下来,跟 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5 摆在一起对了一遍。
先说结论。这是一台偏科很明显的机器,知识工作、长上下文、多模态理解三项它确实站在山顶上,但终端编码和科学推理两个山头它都没拿下来。如果你的选型只看一篇通稿式的发布新闻,大概率会误判它能干什么。
下面是全部数据,表格里的每个分数都能在 DeepMind 官方模型卡里对上,第三方数据单独标了来源。
参数全表,先搞清楚这 1M 窗口的玩法
评测之前把规格钉死,不然对比没有意义。
| 参数项 | Gemini 4 Argon |
|---|---|
| 模型代码 | gemini-4-argon |
| 架构 | 稀疏混合专家(MoE)Transformer |
| 上下文窗口 | 1,048,576 Token(输入、思考、输出共用) |
| 单次输出上限 | 65,536 Token(非流式 32,768) |
| 长解码上限 | 1,048,576 Token(原生 API 续写) |
| 输入模态 | 文本、图片、视频、音频、PDF |
| 知识截止 | 2026 年 3 月 |
| 思考档位 | 低、中、高 |
| 工具 | 函数调用、代码执行、搜索与地图接地、URL 上下文、文件搜索、计算机使用(预览) |
| 缓存 | 仅隐式缓存,输入价的 5% |
两个容易踩坑的细节。一是输出虽然叫 100 万 Token,单次请求只有 65,536,长内容要靠原生 API 的 continuationToken 一次一次接。二是缓存只有隐式模式,官方给的命中门槛是共享前缀至少 6,144 Token,短提示词反复发是吃不到折扣的。
计费上还有几个边角容易漏。视频和音频输入按每百万 Token 2 美元单独计价,一篇带画面的东西喂进去,账单里会多出一行。开 Google 搜索接地按每次查询 0.014 美元另算,一次请求可能触发多次查询。缓存存储每小时每百万 Token 收 0.5 美元,长提示词挂缓存过夜是要收保管费的。
对比的三个对手也交代一下。GPT-6 Astra 是 OpenAI 的当前旗舰,Claude Fable 5.1 和 Claude Opus 5.5 是 Anthropic 的双旗舰,这四个是目前第一梯队里能互相打的有选项。
官方 19 项评测全景,13 项第一 5 项失手
这张表是全文的核心,数据直接取自 DeepMind 模型卡,加粗的是该项第一。
| 类别 | 基准 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| 知识工作 | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| 知识工作 | AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| 知识工作 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| 知识工作 | Harvey 法律代理基准 | 19.6% | 5.4% | 6.7% | 3.8% |
| 代理编码 | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| 代理编码 | FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| 代理编码 | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| 代理编码 | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| ML 工程 | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 科学数学 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| 科学数学 | LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| 科学数学 | RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| 长上下文 | GraphWalks(至 128k) | 99.7% | 98.7% | 91.4% | 90.6% |
| 长上下文 | GraphWalks(256k 至 1M) | 84.2% | 71.8% | 65.0% | 66.8% |
| 计算机使用 | Agent’s Last Exam | 39.5% | 34.2% | — | 38.2% |
| 计算机使用 | OSWorld-2.0(离线子集) | 69.2% | 72.6% | — | — |
| 多模态理解 | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| 多模态理解 | LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| 网络安全 | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
数一下,19 项里 Argon 拿了 12 项第一外加 1 项并列(CWE-bench 跟 Astra 同分),失手 5 项。看起来是碾压,但失手的那 5 项恰好都集中在工程落地侧,这个分布比胜负数量更值得琢磨,后面单独说。
顺带看一下这 19 项的构成。知识工作 4 项、代理编码 4 项、ML 工程 1 项、科学数学 3 项、长上下文 2 项、计算机使用 2 项、多模态理解 2 项、网络安全 1 项,DeepMind 这套卷子明显是按「旗舰模型的真实工作场景」出的,没有那种背课文式的常识问答,含金量比上一代发布时的评测清单高不少。
模型卡的评测时间是 2026 年 10 月,方法论链接就挂在表格底下,有疑虑可以自己去复核。
第三方怎么看,Artificial Analysis 给了 52.6
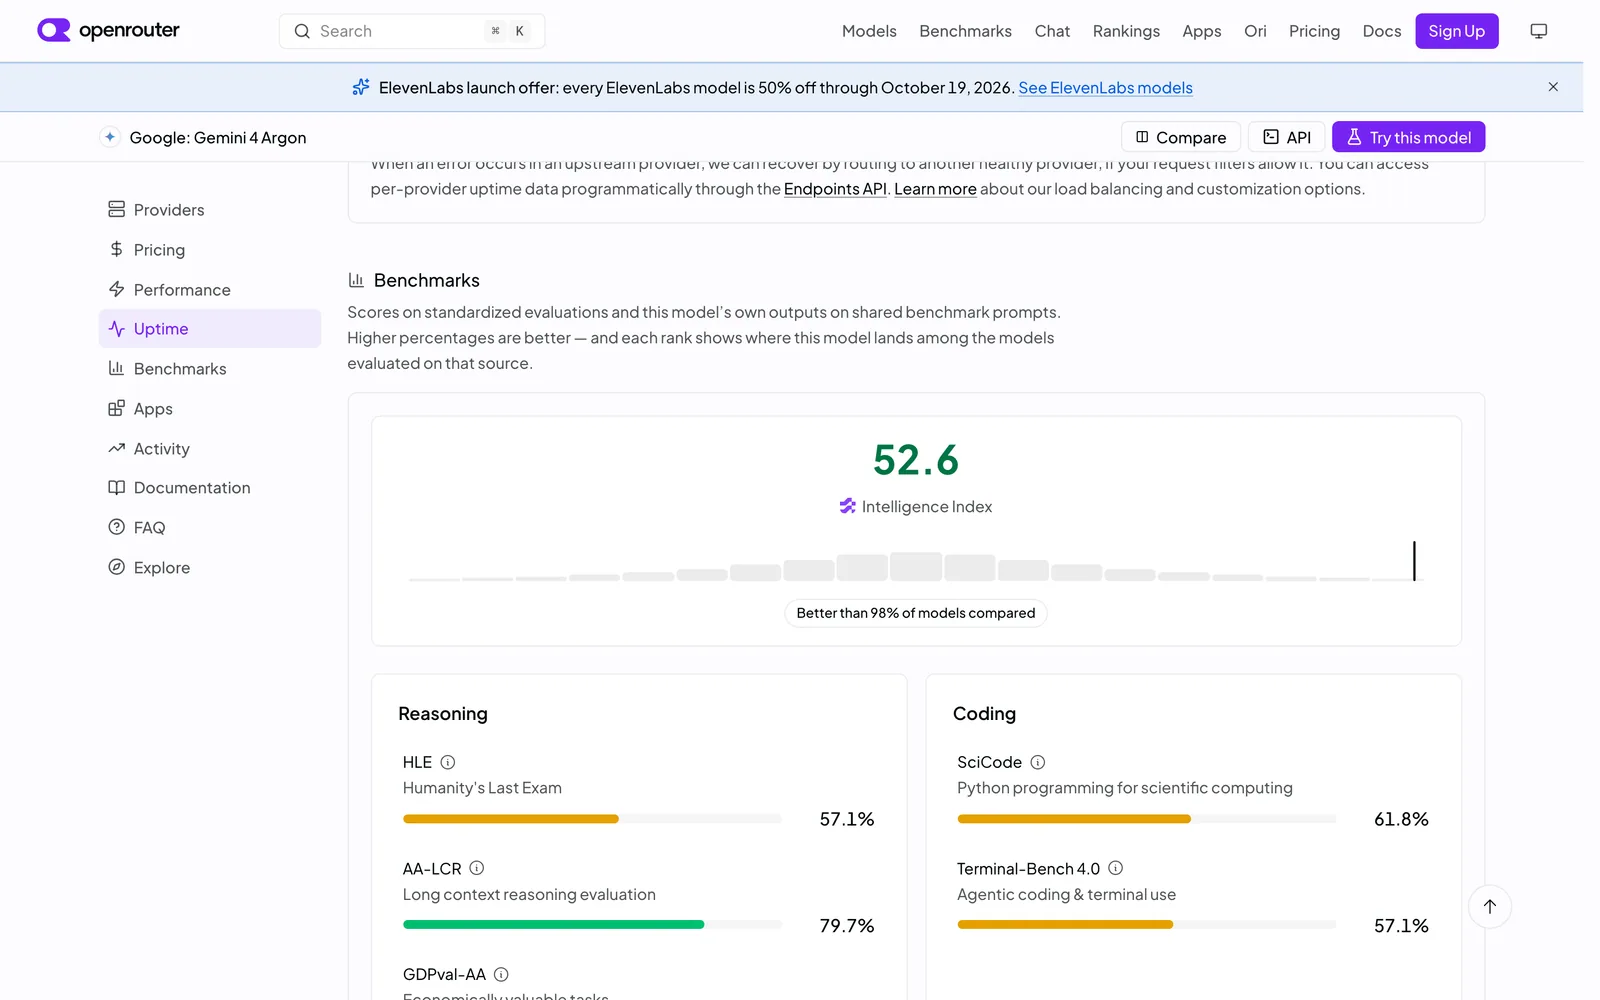
官方数据要打个折扣听,毕竟是自己出卷自己考。第三方机构 Artificial Analysis 的独立评测同步出了,我在 OpenRouter 的模型页上截了它的分数面板。
| 基准(High 档) | 分数 |
|---|---|
| AA 智能指数 | 52.6(超过 98% 的受评模型) |
| HLE(人类最后考试) | 57.1% |
| AA-LCR(长上下文推理) | 79.7% |
| GDPval-AA(经济价值任务) | 56.2% |
| CritPt(科研级物理推理) | 27.1% |
| SciCode(科学计算编程) | 61.8% |
| Terminal-Bench 4.0 | 57.1% |
| AA-Omniscience 准确率 | 49.9% |
| AA-Omniscience 幻觉规避率 | 84.9% |
交叉印证下来,两条线的大方向是一致的,推理和长上下文确实是第一梯队,科研级物理推理(CritPt 27.1%)确实是短板。幻觉规避率 84.9% 这个数字也说得过去,不算顶级但没拖后腿。
给不熟悉这套评测的朋友补一句背景。AA 智能指数是 Artificial Analysis 把十来项硬核基准加权合出来的一个综合分,业内一般拿它当第三方体温计用,HLE 则是一组刻意出得极难、专治旗舰模型眼高手低的考题,57.1% 在当前这批模型里是拿得出手的成绩。官方自评加第三方横评两边一起看,能滤掉大部分发布通稿的水分。
知识工作是真的强,法律代理拉开近三倍
把赢的项目摊开看,成色最足的是知识工作这一组。
Harvey 法律代理基准 19.6% 对手的最高分是 6.7%,差距接近三倍,这个量级的领先在旗舰模型的横评里非常罕见。AutomationBench 领先第二名 8.8 个百分点,Vals Finance Agent v2 领先 6.5 个百分点。翻译成人话,处理合同、财报、税表、案例卷宗这类文档密集型工作,Argon 目前是四个旗舰里最靠谱的。
这组分数对做行业工具的人参考价值最大。法律科技、财税自动化、尽调报告这些赛道的团队,之前普遍把文档理解环节留给专精模型,Argon 在通用模型里第一次把这条线拉到了能打的程度,值得拉出来重测一轮。
长上下文那两格也值得单独看。128k 以内大家都是 90 分上下,拉到百万 Token 区间,别人掉到 65% 到 72%,它还有 84.2%。也就是说 1M 窗口不是营销数字,是真的能干活的范围。
多模态这组赢在稳定,图表理解和长视频理解双双第一,做数据报表解读、视频内容分析这类活可以放心交给它。
编码和科学不是第一,别被旗舰两个字骗了
这部分是我觉得比赢的清单更有信息量的部分。
Terminal-bench 4.0,真实的终端环境里跑工程任务,Argon 57.4%,Claude Opus 5.5 拿了 66.4%,差了 9 个点。FrontierSWE v2,Argon 55.0% 垫底,GPT-6 Astra 65.5%。Terminal-Bench Science,Astra 68.1%,Argon 57.6%。OSWorld 的计算机操作,也是 Astra 领先。
也就是说,离真实开发环境越近的任务,Argon 的排名越往后掉。Vibe Code Bench 这种偏代码生成的题它能拿 91.9%,但到了要自己在终端里折腾环境、连续执行命令、处理意外报错的时候,Claude Opus 5.5 和 GPT-6 Astra 都比它稳。
这个分布其实很好解释。MoE 架构加上海量文档语料的训练取向,造就了它的文档理解和长检索能力,但 agent 式编码要的是另一套东西,长程工具调用的稳定性和对执行环境的感知,这块 Anthropic 和 OpenAI 积累更深。模型卡自己的能力描述里写的也是深度调查、工程任务、文档分析,没敢吹终端编码第一。
还有一层值得想。Claude Opus 5.5 在 Terminal-bench 4.0 上 66.4% 的成绩说明终端代理这件事拼的不是智力上限,是在几十步连续操作里不犯蠢的稳定性,这跟 GraphWalks 那种一次前向的长检索是完全不同的能力项。Argon 的思考档位给了 low 到 high 的调节空间,跑终端任务时把思考预算拉满能不能追回来一些,值得实测,但至少从发布时的默认表现看,它不是这个赛道的领跑者。
所以如果你的主战场是让模型在终端里自己干活,现在换模型不是好时机。这个判断跟发布新闻里的「全面领先」之间的落差,就是我写这篇的原因。
价格放在同行里看,首发价是上车窗口
性能聊完聊钱。Argon 的官方定价对比表我放在这里,Gemini 家族内部用 EvoLink 公开的费率数据。
| 模型 | 输入 / 输出(每百万 Token) | 上下文 |
|---|---|---|
| Gemini 4 Argon(首发价) | $2.00 / $10.00 | 1.05M |
| Gemini 4 Argon(12 月起标准价) | $4.00 / $20.00 | 1.05M |
| Gemini 3.8 Flash | $0.675 / $3.375 | 1.05M |
| Gemini 3.1 Pro | $1.865 / $11.183 | 1.05M |
三个观察。
第一,首发价的 Argon 比标准价的上一代 3.1 Pro 还便宜,输出端便宜 10%,这是 Google 在明示让你迁移。第二,12 月恢复 $4/$20 之后,价格直接翻倍,长期成本模型要按标准价算。第三,Flash 系列依然是性价比之王,量大管饱的常规任务没必要硬上 Argon,它的价值在那些真正需要百万上下文和深度推理的场景。
往竞品那边看一眼,这个定价的进攻性更明显。GPT-6 Astra 和 Claude Opus 5.5 的 API 牌价都在 Argon 标准价之上,Google 用首发价再叠一层折扣,摆明了是要在这一个半月里抢工作负载。对用户这是好事,旗舰模型的价格战上次打到这个烈度,还是 DeepSeek V4 降价那阵子,最后受益的都是调 API 的人。
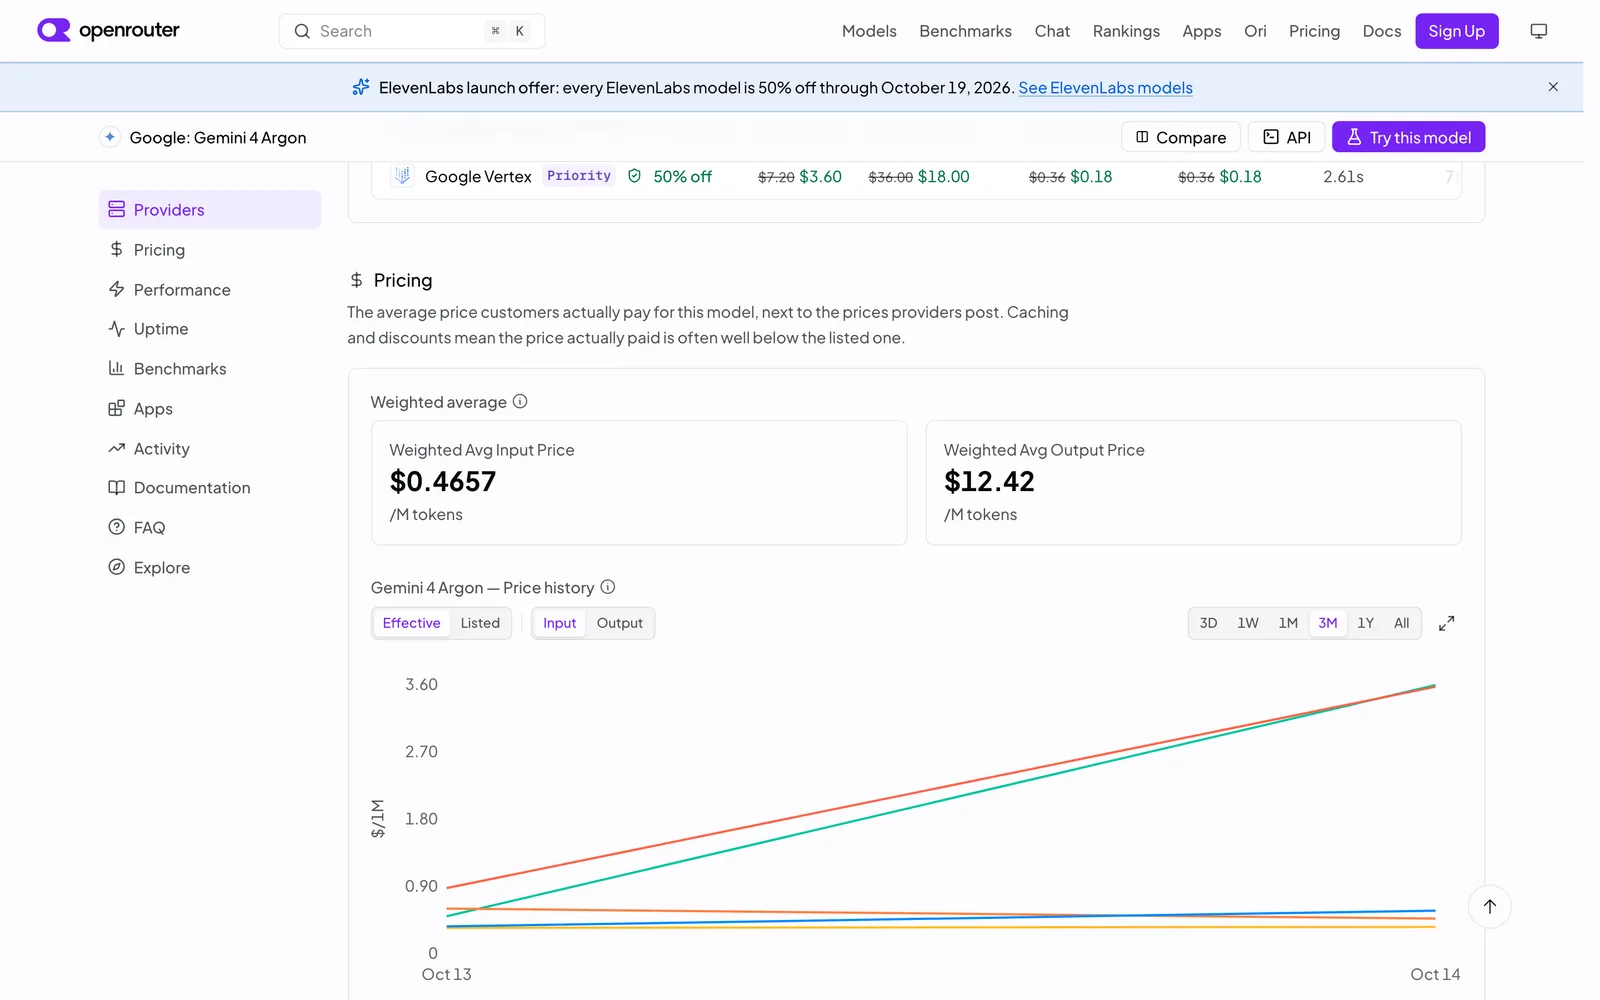
聚合平台那边,OpenRouter 上线三天的真实计费数据是输入加权平均 $0.43、输出 $10.08,缓存命中率拉高了实际输入成本的下降空间,这个数据比牌价更接近你实际会花的钱。
选型建议,什么活交给 Argon
把上面所有数据拧成一个可执行的决策参考。
适合切给 Argon 的活。合同与财报等长文档的分析审查,金融法律税务领域的代理任务,百万 Token 级别的代码库或资料库问答,图表与长视频理解,需要引用大量上下文的深度写作。
应该留在原地的活。终端环境里的 agent 编码继续用 Claude Opus 5.5,科研级推理和科学计算用 GPT-6 Astra,高频低难度的批量任务继续用 Gemini 3.8 Flash 省钱。
还有一条务实建议,迁移生产流量之前,拿自己真实的任务跑一轮并排测试,benchmark 分数是公开考题的成绩,你的私有任务才是闭卷考试。聚合平台的好处就是一把 API Key 能把这几个模型全部拉出来对打。
具体可以这么做。挑 20 到 50 条有代表性的真实任务,记录每条的任务号、用的模型、请求设置和验收结果,跑完对比通过率、重试次数、输出 Token 数和总花费四个数。迁移和回滚的路由都提前测通,别等线上出了问题才发现回不去。
常见问题
Gemini 4 Argon 的上下文窗口是多大?
1,048,576 个 Token,输入、思考与输出共用,单次请求最多输出 65,536 Token,原生 API 可续写至 100 万 Token。
Gemini 4 Argon 和 GPT-6 Astra 哪个强?
知识工作、长上下文检索、多模态理解 Argon 领先,终端编码、科学推理、计算机操作 Astra 领先,按任务类型选而不是按品牌选。
Gemini 4 Argon 编码能力怎么样?
代码生成本身很强(Vibe Code Bench 91.9%),但终端代理编码不是第一,Terminal-bench 4.0 输给 Claude Opus 5.5 约 9 个百分点。
Gemini 4 Argon 价格多少?
首发价每百万输入 $2、输出 $10,2026 年 12 月 1 日起恢复 $4 和 $20,缓存输入为输入价的 5%。
这些评测数据可信吗?
官方 19 项来自 DeepMind 模型卡并附方法论链接,第三方 Artificial Analysis 数据与之方向一致,但官方评测仍是厂商自考,关键业务以自有任务实测为准。
知识截止是什么时候?
2026 年 3 月,之后发生的事它不知道,需要联网事实要在请求里开启 Google 搜索接地(每 $0.014 一次查询另计)。
和 Gemini 3.8 Flash 怎么选?
日常批量任务选 Flash,成本低三分之二;长文档分析、复杂推理、多模态理解再上 Argon。
把 19 项评测抄完,我对 Gemini 4 Argon 的一句话概括是,一台为文档和长上下文而生的旗舰,不是一台全能旗舰。
它把知识工作、百万 Token 检索、多模态理解三条线做到了现役最强,代价是终端编码和科学推理把第一让给了对手。这种取舍在参数上写得清清楚楚,只是发布通稿不会替你划重点。
想先上手试的话,我在这篇发布速递里整理了所有渠道和首发价的截止时间。首发价 11 月 30 日结束,留给你实测的时间不多,把最有代表性的那批任务翻出来,让它跟现役模型打一轮,答案自然就出来了。
以上。