Gemini 4 Argon 正式发布,Google 旗舰推理模型带来 100 万 Token 长输出
事情是这样的。9 月 30 日 Google 放出官宣,隔了不到两周,10 月 13 日 DeepMind 把模型卡和 API 文档一起挂了出来,Gemini 4 Argon 正式发布,AI Studio、Vertex AI、Gemini App 全部同步上架,OpenRouter 当天也能刷到这张模型卡了。
我昨天晚上刷到模型卡的时候还愣了一下,因为这次 Google 没有搞预览版排队那一套,直接就是稳定版,模型代码就叫 gemini-4-argon,没有后缀,没有实验标签。这种发布节奏在 Gemini 家族里还是头一回。
这篇把发布信息、核心参数、价格和上手方式一次整理完,数字全部对过官方文档和模型卡,你直接往下看就行。
发布时间线,官宣到全渠道只用两周
先把时间线捋清楚。
9 月 30 日,Google 公布 Gemini 4 系列的存在,给出开放顺序。10 月 13 日,DeepMind 发布 Gemini 4 Argon 模型卡,同一天 AI Studio、Vertex AI、Gemini App、Google Antigravity 这些渠道全部可用,OpenRouter 上也挂出了模型页,标注的发布日期就是 10 月 13 日。
各渠道的形态简单说一下。AI Studio 是网页即开即用的开发者后台,适合上手试;Vertex AI 面向企业,走 Google Cloud 的计费与合规体系;Gemini App 是消费端入口,订阅用户直接在对话里用;Antigravity 是 Google 自家的编码代理产品,Argon 进去当主力模型。同一个模型四种吃法,你可以按自己的身份挑入口,模型行为是一致的。
从官宣到全渠道两周不到,这个节奏比 Gemini 3 系列当年快了不少。模型卡里写得很明白,这是一个全新训练的前沿模型,不是在上一代基础上改出来的微调版,架构是大规模稀疏混合专家(MoE),训练跑在 Google 自家的 TPU Pods 上,框架是 JAX 和 ML Pathways。
顺带说一句,模型卡连安全评估都一起公开了,知识截止日期是 2026 年 3 月,这块在选购的时候要心里有数。
安全那部分的数据其实挺有意思。跟上一代 Gemini 3.1 Pro 比,多语种安全性和图文安全性分别改善了 3.16 和 9.29 个百分点,无理拒绝减少了 9.6 个百分点,也就是你让它帮忙写点擦边题材的小说,它胡乱罢工的概率小了不少。前沿安全框架评估里,生物和网络安全两个领域的能力浓度触发了观察线,Google 说已经部署了对应的防护措施,这类披露在两年前是不可想象的,现在都成了旗舰发布的标配动作。
核心参数速览,统一 1M 窗口是最大的变化
看参数之前,先放一张官方文档的属性表,这张表基本把关键信息都圈出来了。
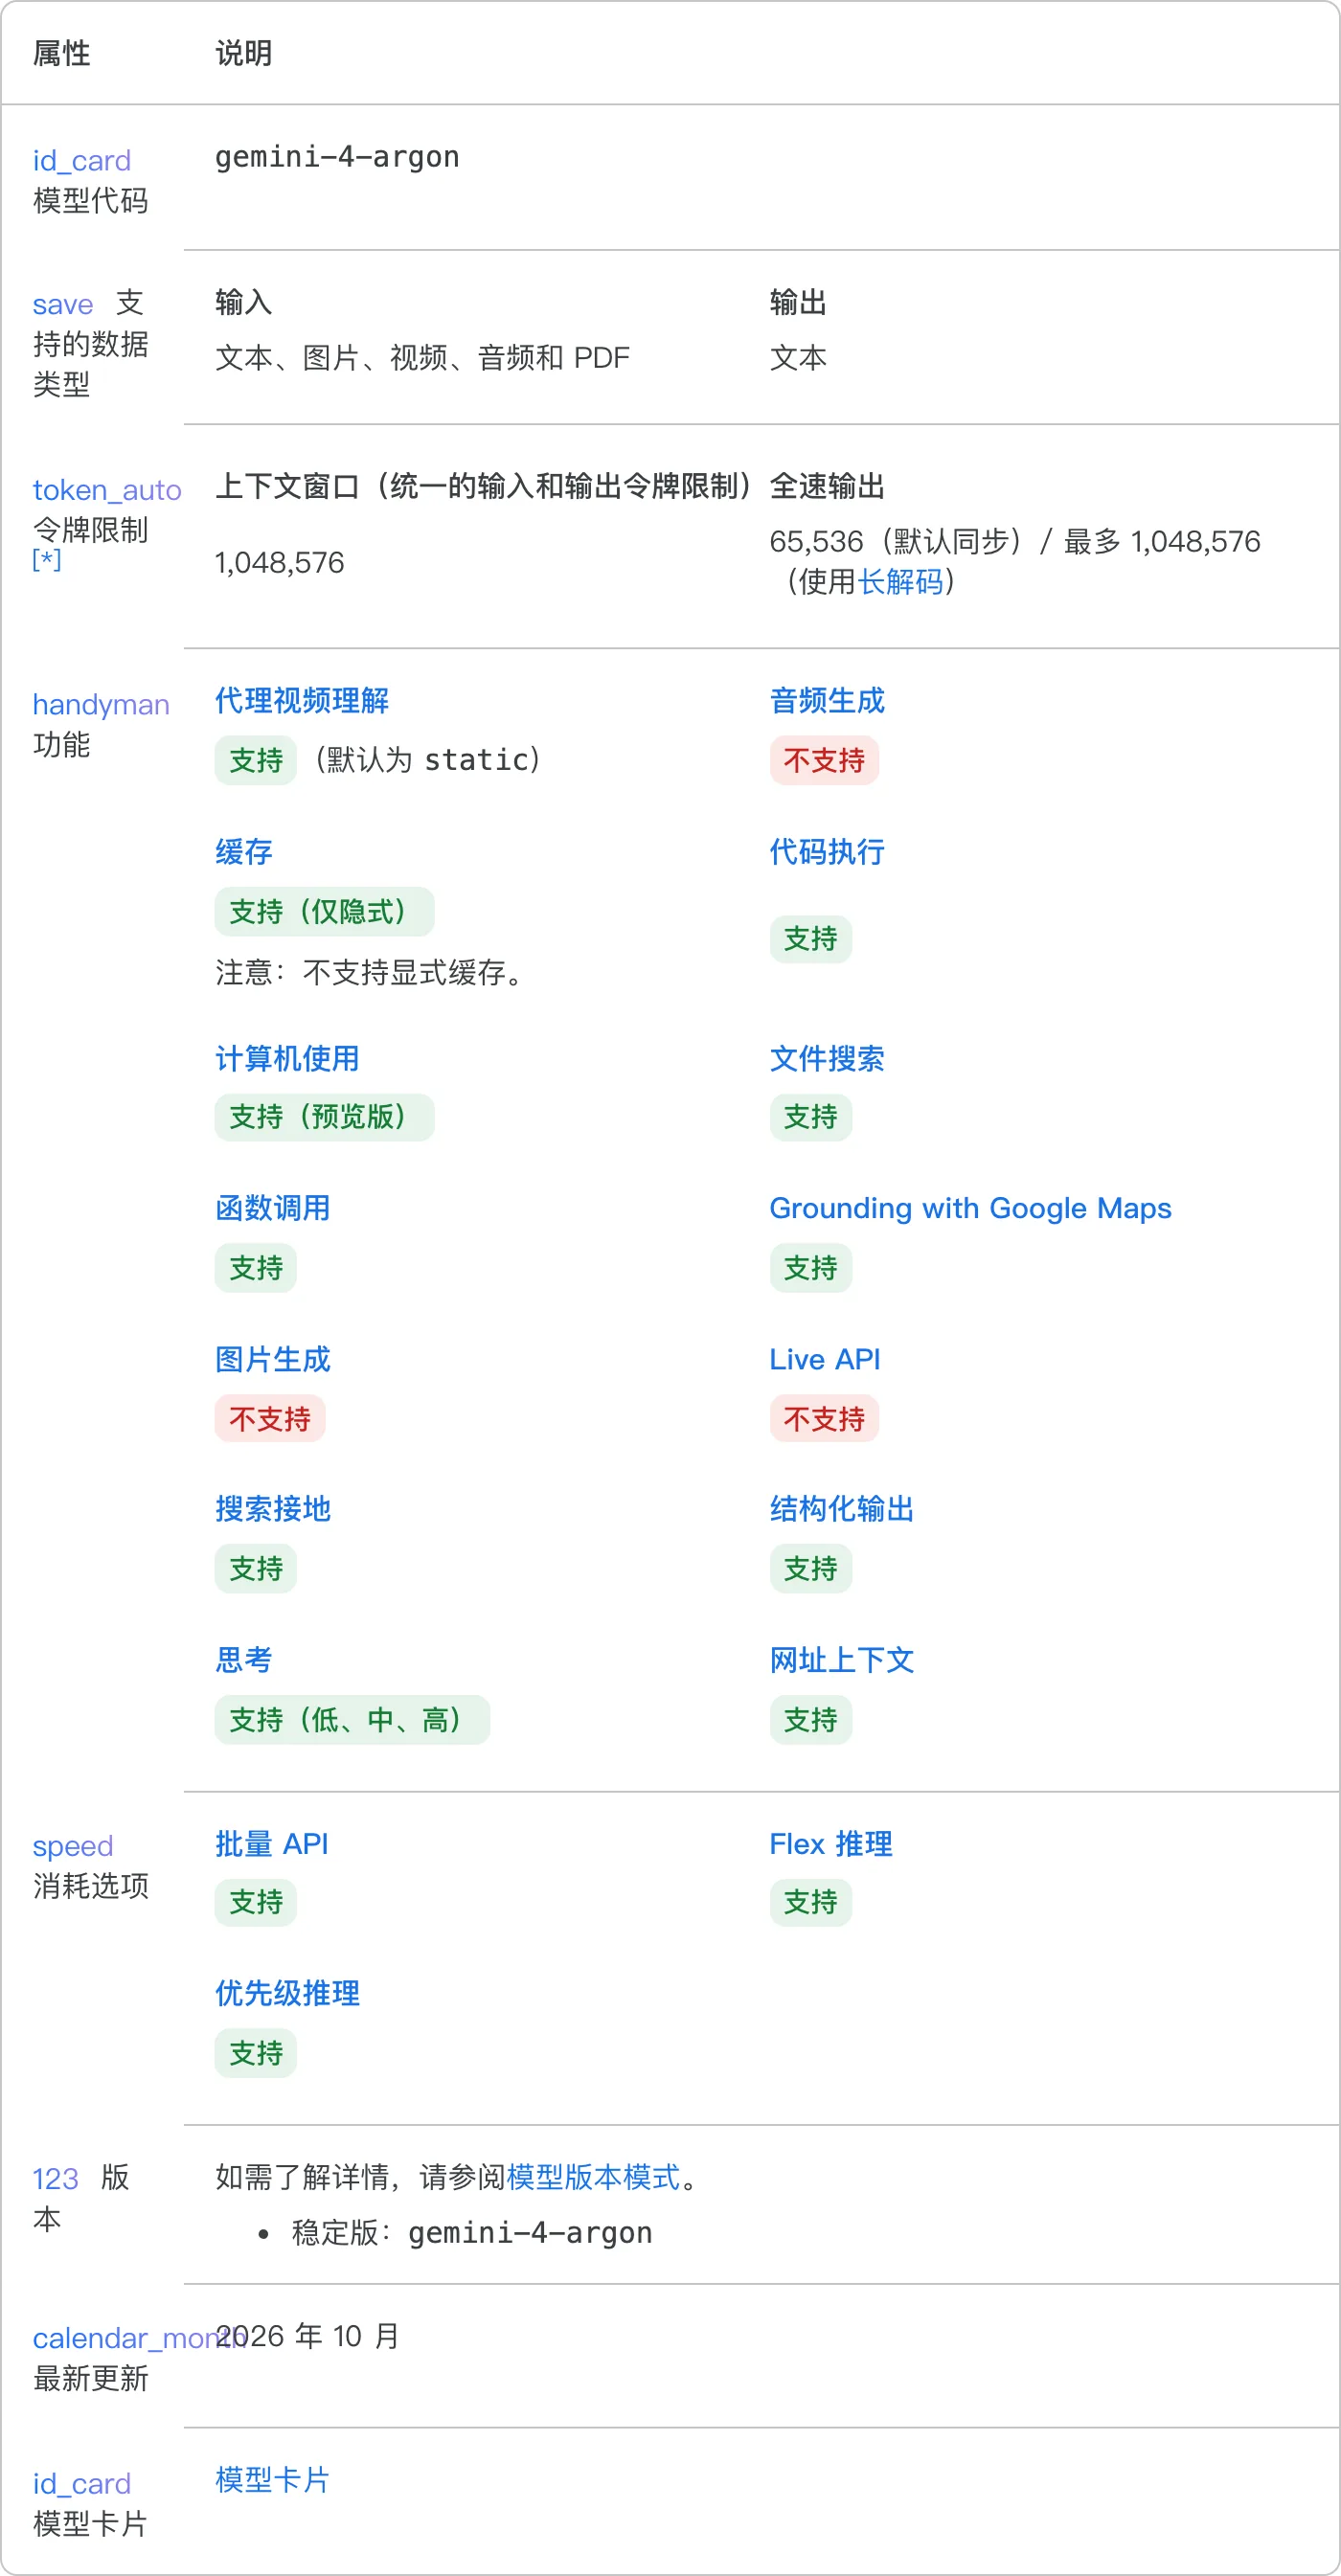
我把它整理成了速览表,数字全部来自官方文档。
| 参数项 | Gemini 4 Argon |
|---|---|
| 模型代码 | gemini-4-argon |
| 上下文窗口 | 1,048,576 Token(输入、思考、输出共用) |
| 单次输出上限 | 65,536 Token(非流式 32,768) |
| 长解码上限 | 1,048,576 Token |
| 输入模态 | 文本、图片、视频、音频、PDF |
| 输出模态 | 文本 |
| 知识截止 | 2026 年 3 月 |
| 思考档位 | 低、中、高三档可调 |
这里最值得说的是上下文的记法。Argon 不再区分输入窗口和输出窗口,1,048,576 个 Token 是一个统一的大池子,你喂进去的文档、模型的思考过程、吐出来的回答,都从这一个池子里扣。实际用起来,这种统一记法比上一代那种输入 1M 加输出 64K 的拆法清爽太多,你不用再心算还剩多少输出额度。
另外音频和视频输入是直接吃的,官方把代理视频理解默认设成了 static 模式,要做实时视频流得自己切设置。
消耗选项也值得交代一下,Batch API、Flex 推理、优先级推理三个都支持。翻译一下,不着急的离线任务走批处理能省钱,赶时间的实时任务可以加钱买优先算力,同一个模型三种花法,这个灵活度在 API 产品里算给得很足了。
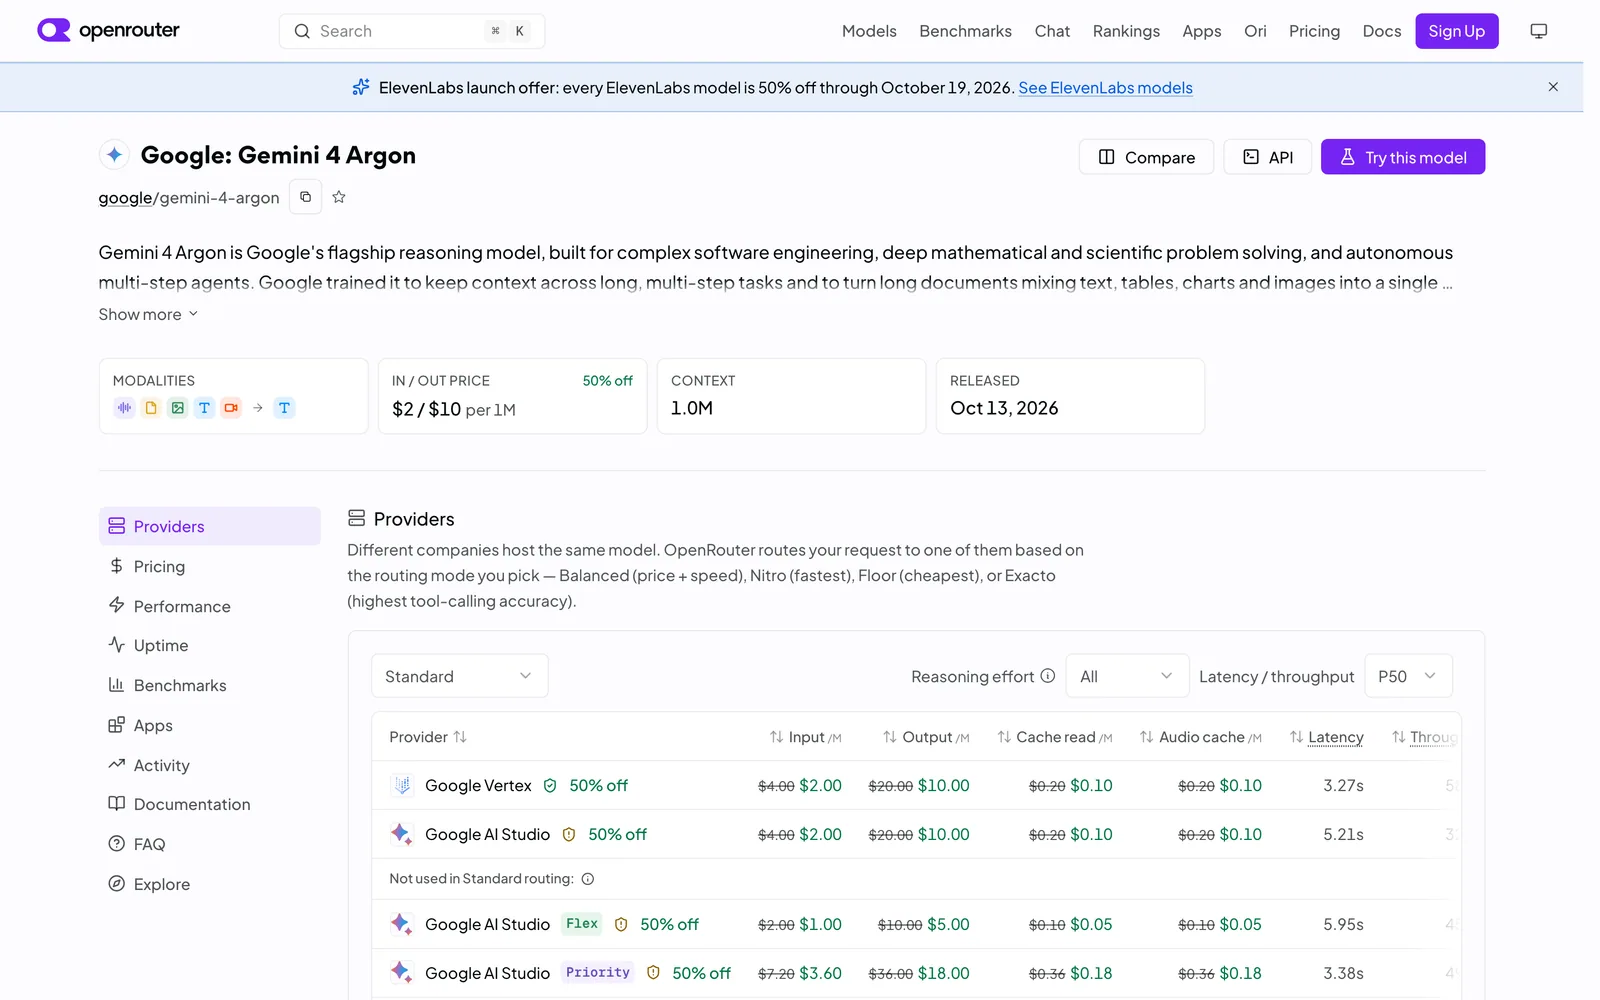
实际上线后的表现也有参考数据。OpenRouter 上线三天,Google Vertex 通道的首 Token 延迟 2.83 秒,吐字速度 60 Token 每秒,可达性 99.81%,作为刚上线的旗舰模型这个成绩算稳的,至少没有重演某些模型发布首周挤爆门口的盛况。
100 万 Token 长输出怎么用,续写机制是关键
参数表里藏着一个很多人会忽略的细节,单次请求其实最多只返回 65,536 个思考加回答 Token,非流式还要砍半,只有 32,768。
那 100 万 Token 的长输出是怎么来的。
答案是续写。在 Gemini 原生 API 上,当响应以 CONTINUATION 状态结束时,会带一个 continuationToken,你拿着它原样重发同一个请求,模型就从断点接着写,直到以 STOP 结束。理论上你可以这样一直接下去,累计写到 100 万 Token。
我用一个具体的场景感受一下这个量级。一部 20 万字的书稿,或者一份带全部图表的年度财务报告,或者一个完整代码仓库的全部文档,都可以在一次会话里让它写完或者读完。OpenRouter 给这个能力起了个名字叫 long decode,单响应最长 100 万 Token,这在目前的旗舰模型里是独一份,GPT-6 Astra 和 Claude Fable 5.1 都没有开到这个量级。
要注意的是 Chat Completions 协议不支持续写,顶到上限就会被截断,finish_reason 显示 length。想用满这个能力,得走原生 API。
给个直观的参照,65,536 Token 大概是一本 10 万字的书,也就是说单次请求就能让它给你写完一整本。而续写拉满的 100 万 Token,相当于让它一口气写十本。写长篇连载、批量生成课程讲义、把一个代码库的全部注释重写一遍,这类以前必须切成几十次请求的活,现在一次排队就能跑完,中途上下文还不会丢。
有一个成本细节要提醒。思考 Token 和回答 Token 都从那个统一池子里扣,计费时思考部分按输出价算。把思考档位开到 high 跑长任务,账单上输出那一栏会比你想的长,预算紧张的任务记得先把档位降到 medium 对比一下质量差,很多时候 low 和 high 的差距没有价格差距大。
首发价 2 美元输入 10 美元输出,12 月 1 日涨价
价格这块信息量比较大,我拆成两张表说。
第一张是官方定价的时间窗口。
| 阶段 | 输入(每百万 Token) | 输出(每百万 Token) | 缓存输入 |
|---|---|---|---|
| 首发价(至 2026-11-30) | $2.00 | $10.00 | $0.10 |
| 标准价(2026-12-01 起) | $4.00 | $20.00 | $0.20 |
首发价打了对折,截止日期是 2026 年 11 月 30 日,12 月 1 日起恢复标准价。也就是说接下来一个半月是上手试成本的最好窗口,跑通了再决定要不要长期用。
对比一下上一代,首发价的 Argon 比标准价的 Gemini 3.1 Pro 还便宜,输出端便宜大约一成,输入端基本持平。用官方牌价逼着用户从 3.1 Pro 往新模型迁,这个意图已经写在价格表上了。手里还有老模型生产流量的,这一个半月正好做迁移验证。
第二张是周边计费项,这些不影响上手但影响账单。
| 计费项 | 价格 |
|---|---|
| 缓存输入读取 | 输入价的 5%(首发 $0.10/百万) |
| 缓存命中门槛 | 共享前缀至少 6,144 Token,自动生效 |
| Google 搜索接地 | $0.014 / 次查询 |
| 视频与音频输入 | $2.00 / 百万 Token |
| 缓存存储 | $0.50 / 小时 / 百万 Token |
缓存这块要多说一句,Google 把缓存输入价格压到了输入价的 5%,这是全场折扣最狠的一项。如果你的场景是反复带着同一段长系统提示词或者同一份参考文档发请求,实际成本能比标价低一大截。OpenRouter 上的真实计费数据也印证了这一点,上线三天缓存命中率在 65% 到 87% 之间,用户实际支付的加权平均输入价格只有 $0.43,远低于 $2 的牌价。
另外 Argon 只支持隐式缓存,不支持显式缓存,这个跟上一代 Pro 系列不一样,做成本模型的时候别按老习惯算。
五个真亮点,从法律代理到自动挖漏洞
模型卡里的评测数据不少,我挑了五个确实拉开差距的点,每一项都给了具体分数。
第一是知识工作。Vals Index 拿了 68.9%,排在 GPT-6 Astra(63.1%)和 Claude Opus 5.5(67.0%)前面,Harvey 的法律代理基准更是拿到 19.6%,同期对比模型最高只有 6.7%。做法律、金融、税务这类文档密集型工作的,这个数字值得认真看。举个具体点的画面,让它通读一份两百页的招股书再交叉核对附注里的财务数据,这类活以前要拆成好几次会话喂,现在整个塞进去一次跑完。
第二是长上下文检索。GraphWalks 基准在 25.6 万到 100 万 Token 区间拿了 84.2%,同场竞技的其他模型最高只有 71.8%。上下文开到几十万 Token 还能记得住细节,这是 1M 窗口真正有意义的证明。做代码库级问答、整卷宗检索、超长会议记录整理的,终于不用再绞尽脑汁做切块了。
第三是网络安全。模型卡里专门提了它能够自主发现、验证并修补软件漏洞,CWE-bench v1 拿了 68.0%。
第四是多模态理解。图表理解基准 Chartography 71.6%,长视频理解 LVBench 91.7%,都是同组第一。拿它读财报图表、过监控录像、做视频内容分析,基础是够的。
第五是代理能力。Agent’s Last Exam 通过率 39.5%,多步工程任务 DeepSWE v1.1 拿了 77.9%。官方给它的定位就是自主多步代理,配的工具链也齐,函数调用、代码执行、文件搜索、URL 上下文、搜索接地,连 Google Maps 接地都给了,计算机使用目前是预览版。拿它搭自动化流水线,周边零件不用东拼西凑。
上面这些强项的完整分数表和输掉的项目,我在这篇评测对比文里逐项拆过,想看全景的可以接着读那篇。
它砍掉了什么,这三个不支持要有数
吹完了得说说砍了什么,这部分官方文档写得很清楚,但很容易被发布新闻忽略。
图片生成不支持。Gemini 4 Argon 是纯理解模型,生图还是得找 Nano Banana 那条线。
Live API 不支持。做实时语音对话的,现阶段还得留在 Gemini Omni Flash 上,音频生成同样不在支持列表里。
显式缓存不支持。前面说了,只有隐式缓存,靠前缀自动命中,你没法手动把一段超长上下文钉在缓存里。
我自己的看法是这三个砍得都不亏,把多模态理解和长文本推理做透,比什么都想沾一点更符合一个旗舰推理模型的定位。但你要是冲着全家桶来的,得知道这张牌桌上它只出了一半的牌。
常见问题
Gemini 4 Argon 是什么时候发布的?
2026 年 9 月 30 日官宣,10 月 13 日模型卡与全渠道正式上架,OpenRouter 等聚合平台同日可用。
Gemini 4 Argon 的上下文窗口多大?
1,048,576 个 Token,输入、思考与输出共用。单次请求最多返回 65,536 Token,更长内容走原生 API 续写,累计可到 100 万 Token。
Gemini 4 Argon 能生成图片吗?
不能。它只输出文本,图片生成要使用 Google 的图像模型产品线。
首发价什么时候结束?
2026 年 11 月 30 日。之后输入从 $2.00 涨回 $4.00,输出从 $10.00 涨回 $20.00(每百万 Token)。
缓存怎么收费?
缓存输入是输入价的 5%,自动命中,要求共享前缀至少 6,144 Token,无法手动指定缓存内容。
支持哪些输入格式?
文本、图片、视频、音频和 PDF 都可以直接输入,输出目前只有文本。
跟 GPT-6 Astra 比该选哪个?
知识工作、长上下文和多模态理解场景 Argon 占优,终端编码与科学推理场景 Astra 的分数更高,建议按自己的任务实测再定。
思考档位可以调吗,怎么计费?
低、中、高三档可调,思考 Token 与回答 Token 都按输出价计费。对成本敏感的任务建议从 medium 起步,实测质量不够再上调。
不着急的任务有便宜用法吗?
有。Batch API 适合离线批量,Flex 推理用等待时间换价格,优先级推理反过来加钱保时效,同一个模型按任务紧急度分流能省不少。
跟 Gemini 3.1 Pro 比值得换吗?
纯参数和分数都是代差级的提升,首发价还比 3.1 Pro 标准价低。手里有跑在 3.1 Pro 上的生产流量,这一个半月的折扣窗口正好用来做迁移验证。
现在去哪用上它
上架渠道里最省事的是 Google AI Studio,登录就能在模型列表里选到 gemini-4-argon,免费额度够你把玩一阵。要接生产 API,Vertex AI 或者 OpenRouter 都是正规入口,OpenRouter 那边还能并排对比其他模型的价格和延迟。
动手路径也简单。AI Studio 里选好模型直接在对话框试,满意了再到 Get API Key 页面领一把钥匙,把模型代码填成 gemini-4-argon 就能调。已有的 OpenAI 兼容代码库迁移成本接近零,换掉模型名就行,思考强度用 low、medium、high 三档调,建议先从 high 跑基准,再往下减预算。
如果你想看它跟 GPT-6 Astra、Claude Fable 5.1 在 19 项基准上的逐项对比,以及到底什么任务该选它什么任务该避开,可以看我整理的评测对比文。对长上下文成本敏感的话,DeepSeek V4 降价那篇也有可以对照的数据。
首发价 11 月 30 日截止,想试的话,这两周就是最好的时候。
以上。